いいね0.5に対して通報は-234:Xの公開コードで読む「おすすめ」の採点と、嫌われない投稿設計8項目
Xが公開した推薦アルゴリズムのコードを、公式の説明書と重みの設定ファイルから読む。いいね0.5に対して報告は-234。この桁違いの減点が「件数」ではなく「読者ごとの確率」に掛かる仕組みと、そこから導いた投稿設計8項目。出典URL付き。
- X運用
- アルゴリズム
結論
Xのおすすめ(For You)は「いいねの数で決まる」と思われがちだ。だが公開コードの採点表では、いいね0.5に対して報告(通報)は-234、ミュートは-58.8。読者に嫌がられる見込みがわずかにあるだけで、いいねされる見込みを大きく打ち消す採点になっている。しかもこの重みが掛かるのは、実際に付いた「いいねの数」ではなく、「投稿を見せる相手ひとりひとりについて、その人がいいねしそうか・通報しそうか」という確率だ。だから、伸ばす工夫より先に「興味のない人に届いたとき嫌がられない」投稿設計を整えるべきだと私は考えている。
この記事は、その根拠になっている公開コードを一次資料の順に読んでいく。前半(§1〜8)は仕組み、後半(§9〜10)は私の解釈と投稿設計だ。実践だけ知りたい人は、§9のチェックリストへ飛んでもらって構わない。
この記事の読み方
一次資料はGitHubで公開されているxai-org/x-algorithmだ。引用する数値は、そのREADME(公開コードに添えられている公式の説明書。以下「説明書」と呼ぶ)と、重みの設定ファイル(param.rs)から2026-09-02時点で読み取った。ファイルの一覧は記事末尾の「参考資料」にまとめてある。
なお、公開コードは4週間ごとに更新して透明性を示すとマスク氏が約束している(TechCrunch 2026-01-20)。数値は変わるので、値の暗記ではなく「どういう構造か」を持ち帰ってほしい。
1. 公開は3回に分かれた
| 時期 | 何が出たか | 出典 |
|---|---|---|
| 2023年3月 | 旧Twitterがアルゴリズムの一部を公開。候補を約1,500件集め、内輪(フォロー中の相手)と外輪(フォロー外)をほぼ半々で混ぜ、Heavy Rankerという採点モデルで並べる構造だった | twitter/the-algorithm |
| 2026年1月20日 | xAIが全面的に書き直した推薦エンジンを公開。Grok-1(xAIのAIモデル)から移植した採点モデルを使う。あわせて、4週間ごとに公開コードを更新して透明性を示すとマスク氏が約束した | 初回コミット aaa167b3・TechCrunch 2026-01-20 |
| 2026年8月13〜14日 | 重みの具体値と、投稿の表示・非表示を決めるフィルタ系のコードを追加公開。コード全体は従来の10〜15倍の規模になった。同時に、自分のアカウントに付いたラベルを見られる透明性ツール「Under the Hood」を試験公開 | 説明書の Notable Updates・TechCrunch 2026-08-13 |
公開されていないものも明記されている。説明書の「What's not in this repo?」には、Grox(投稿の中身を検品するモデル。Grokと1字違いだが別物。§8で説明する)への指示文の本文と、一部のBotmaker(スパム判定などのルールを書く仕組み)のルールが挙げられ、理由は「人々がシステムを攻略するのに使いうるから」とある。つまり「重みは見えるが、スパム判定の急所は見えない」状態だ。
2. 投稿がタイムラインに出るまでの8段階
説明書の「System Architecture」に沿うと、1回の「おすすめ」表示は次の順に組み立てられる。
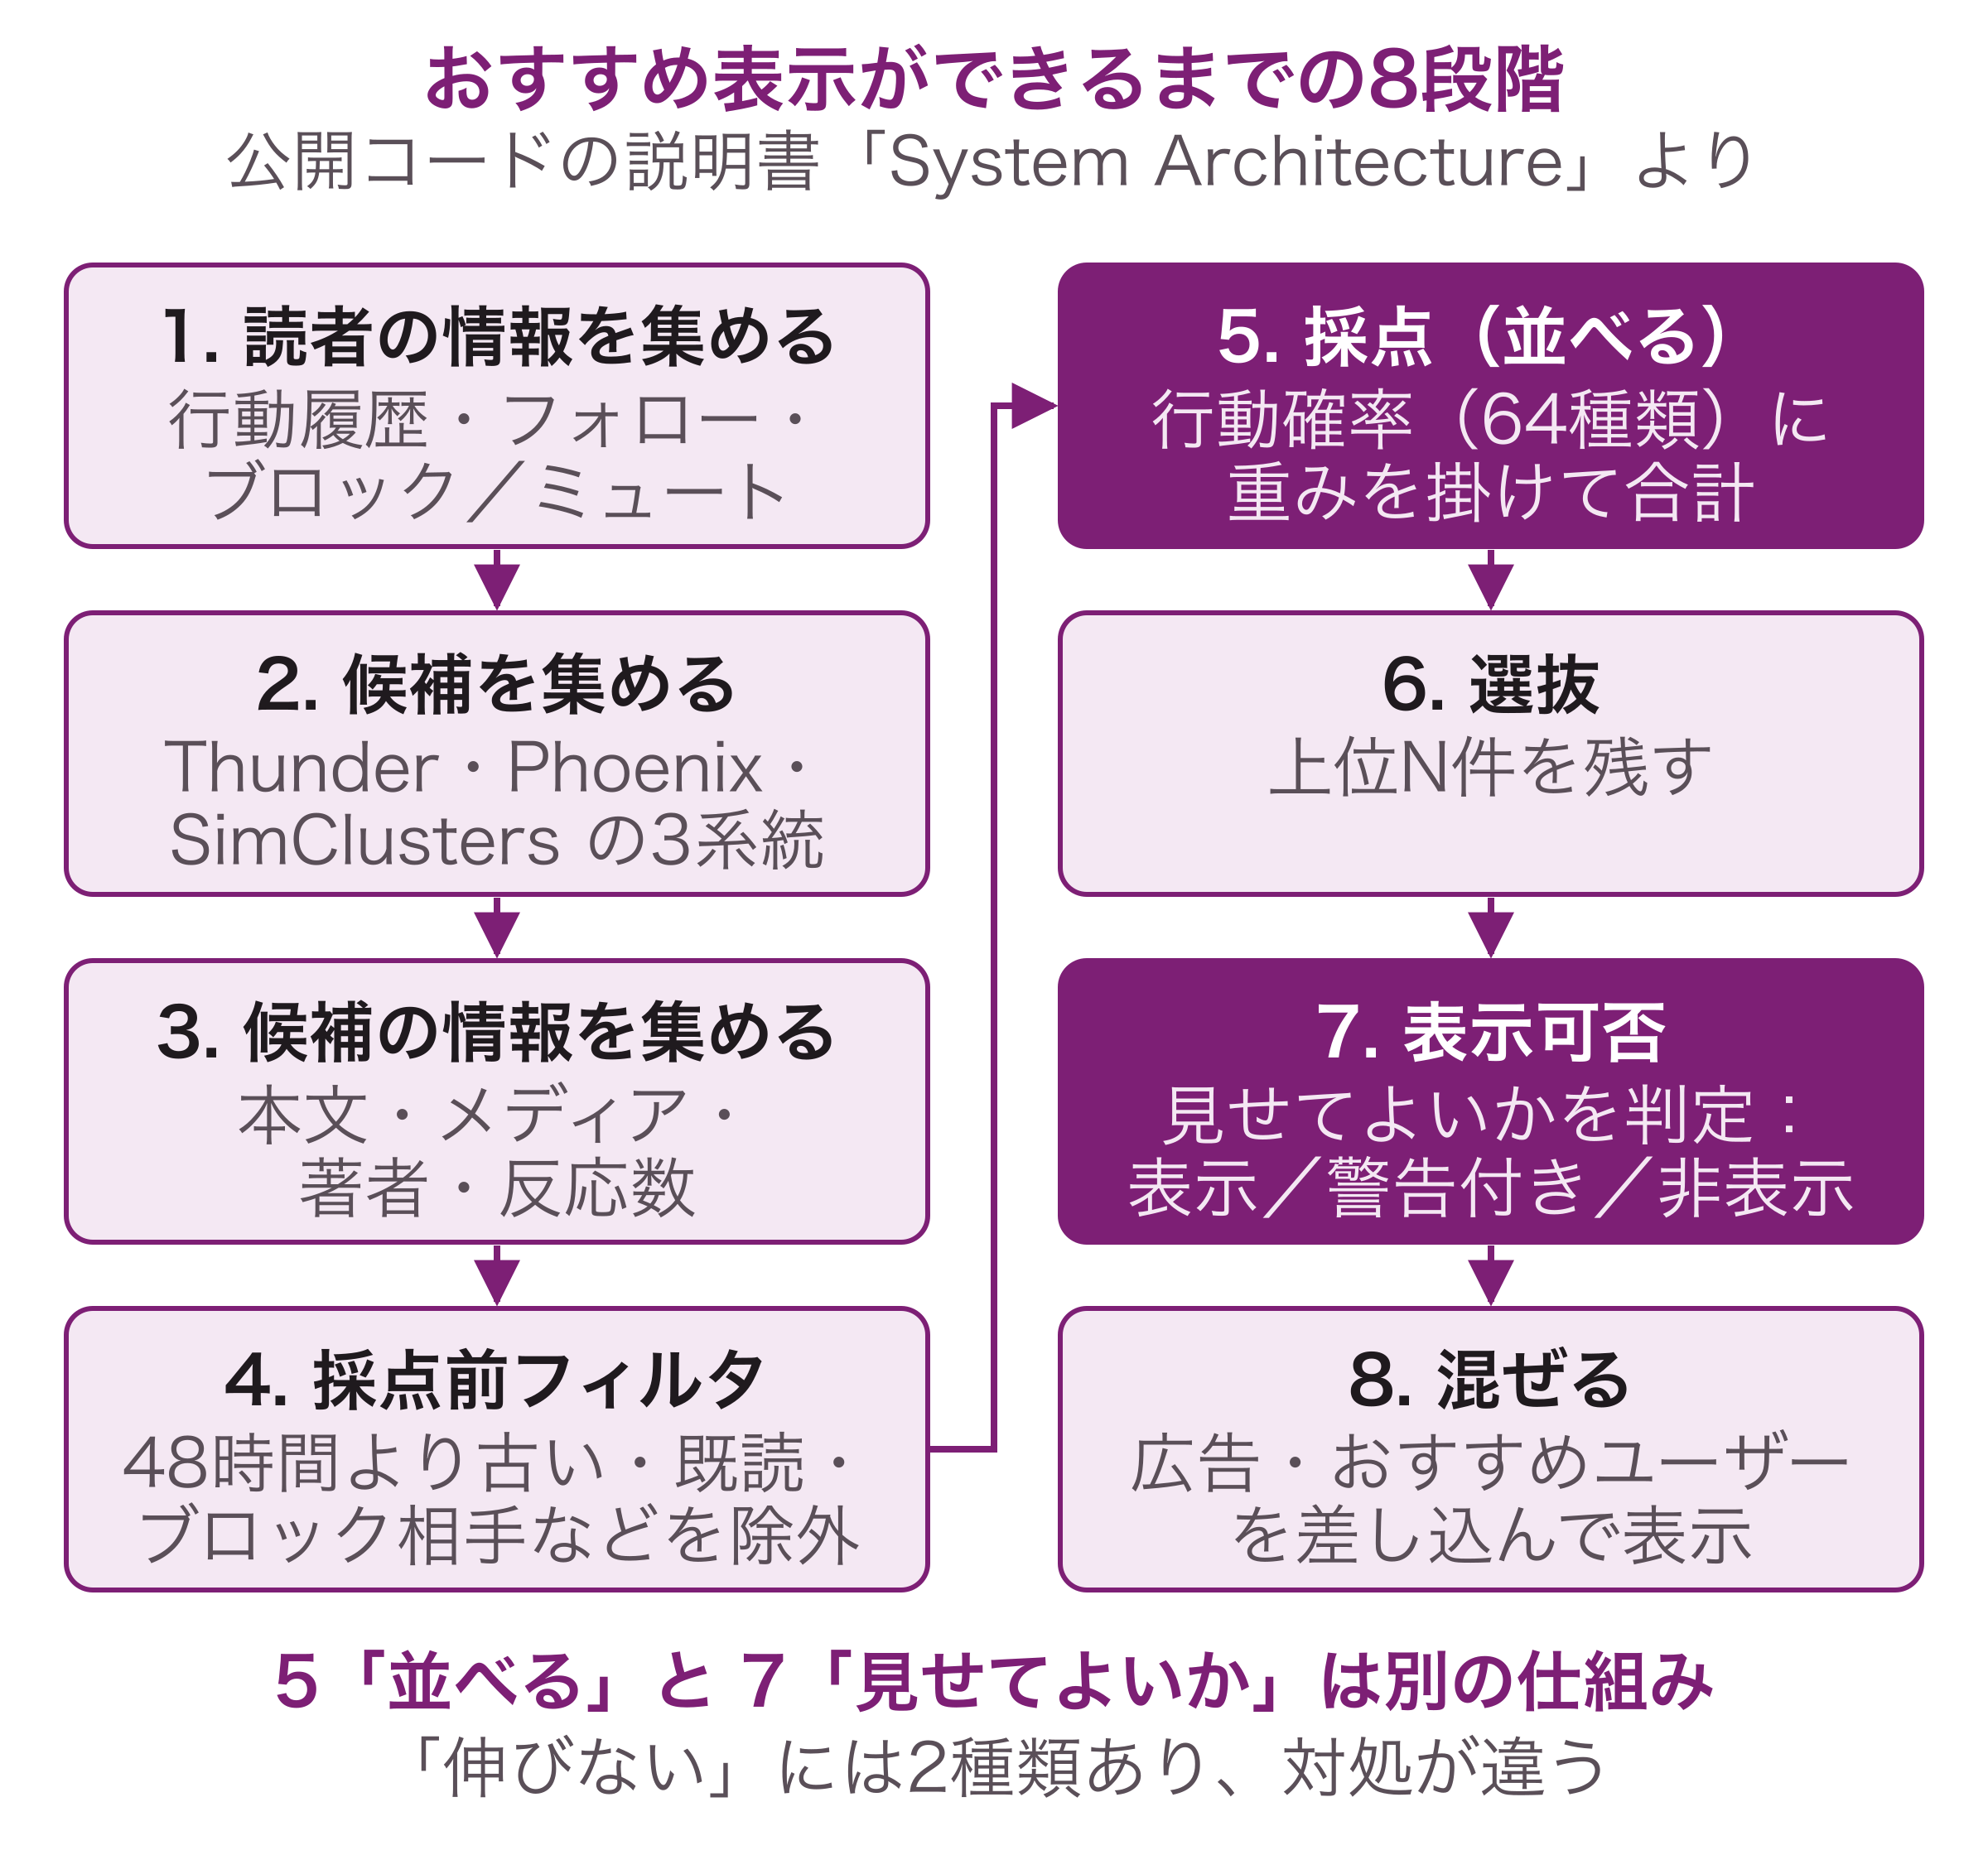
- 読者の情報を集める(Query Hydration)。直近の行動履歴、フォロー一覧、ブロック・ミュート
- 候補を集める(Candidate Sources)。後述の3系統から投稿を集める
- 候補の情報を集める(Candidate Hydration)。本文・メディア・著者・反応数
- 採点前フィルタ(Pre-Scoring Filters)。重複、48時間より古い投稿、ブロック/ミュート相手、既読、ミュートしたキーワードを落とす
- 採点(Scoring)。Phoenixが行動確率を予測し、重みを掛けて合計する
- 選抜(Selection)。上位N件を残す
- 表示可否(Post-Selection Filters)。表示/警告付き/非表示(ALLOW/INTERSTITIAL/DROP)を判定する
- 混ぜる(Blending)。広告・「おすすめユーザー」などを差し込む
ここで押さえてほしいのは、並べる(5)と見せてよいか(7)は別の仕組みだという点だ。説明書の設計方針にも「ランキングと表示可否は分離する」(Ranking and Visibility Are Separate)と明記されている。「伸びない」には「採点で沈んでいる」と「表示可否で止められている」の2種類があり、対処が違う。見分け方と対処は§10で扱う。
3. 候補を集める3つの入口
候補を集める入口は3系統ある(説明書のComponents)。ここから先、フォローしている相手を「内輪」、それ以外を「外輪」と呼ぶ。
| 系統 | 何をするか | 投稿する側にとっての意味 |
|---|---|---|
| Thunder | フォロー中のアカウントの最近の投稿をメモリ上に保持して返す | フォロワーには「候補になる」ところまでは保証される |
| Phoenix retrieval | 読者と投稿をそれぞれ数値の並び(ベクトル)に変換し、数値の上で「内容が近い」投稿を探す | フォローされていなくても「内容が近い」だけで候補になる |
| SimClusters | 「誰が何に反応したか」でアカウントと投稿をクラスタに分ける | 同じ興味の集団に届く |
2023年版では内輪と外輪を約半々で混ぜていた(§1の表のとおり)。2026年版の説明書に比率の明記は無いが、後述の「外輪割引(0.75)」が採点段階で効くため、外輪の投稿は、採点が同じでもスコアが0.75倍(25%減)になる。
4. 採点前フィルタは土俵に乗る条件
採点の前に落とされる条件は明確だ。説明書には、48時間より古い投稿、既に見せた投稿、ブロック・ミュートした相手の投稿、ミュートしたキーワードを含む投稿、重複が挙げられている。
実務での意味は1つ。時事ネタは48時間で候補から外れる。「あとで伸びる」は起きにくい構造なので、鮮度のある話題は当日に出すのが合理的だろう。
5. 採点係のPhoenixは64種類の行動確率を一度に出す
採点係のPhoenixの仕組みは、Phoenixの説明書に書かれている。名前は覚えなくてよい。「採点する係」とだけ押さえておけば十分だ。
入力は読者の直近1,022件の行動履歴(執筆時点の設定値)と、候補投稿の特徴だ。投稿は本文の文字がそのまま渡るわけではない。本文と画像・動画の内容を、図書館の分類コードのような短い記号列、いわば「意味ID」に要約して渡す。誰が書いたか(著者ID)も、元の値が分からない形に変換される。
出力は「この読者がこの投稿に対して各行動をとる確率」で、64種類の離散行動(いいね・返信・リポスト・引用・共有の各種・クリック・「興味なし」・ミュート・ブロック・報告など)と8種類の連続値(滞在時間など)を、1回の推論で同時に出す。
Phoenixが確率を出す段階では、候補どうしは互いを参照しない。隣に何が並ぶかで確率は変わらない。
初期公開版は「Grok-1のオープンソース版から移植したサンプル」だったが、現在は「本番実装そのもの」だと説明書に書かれている。
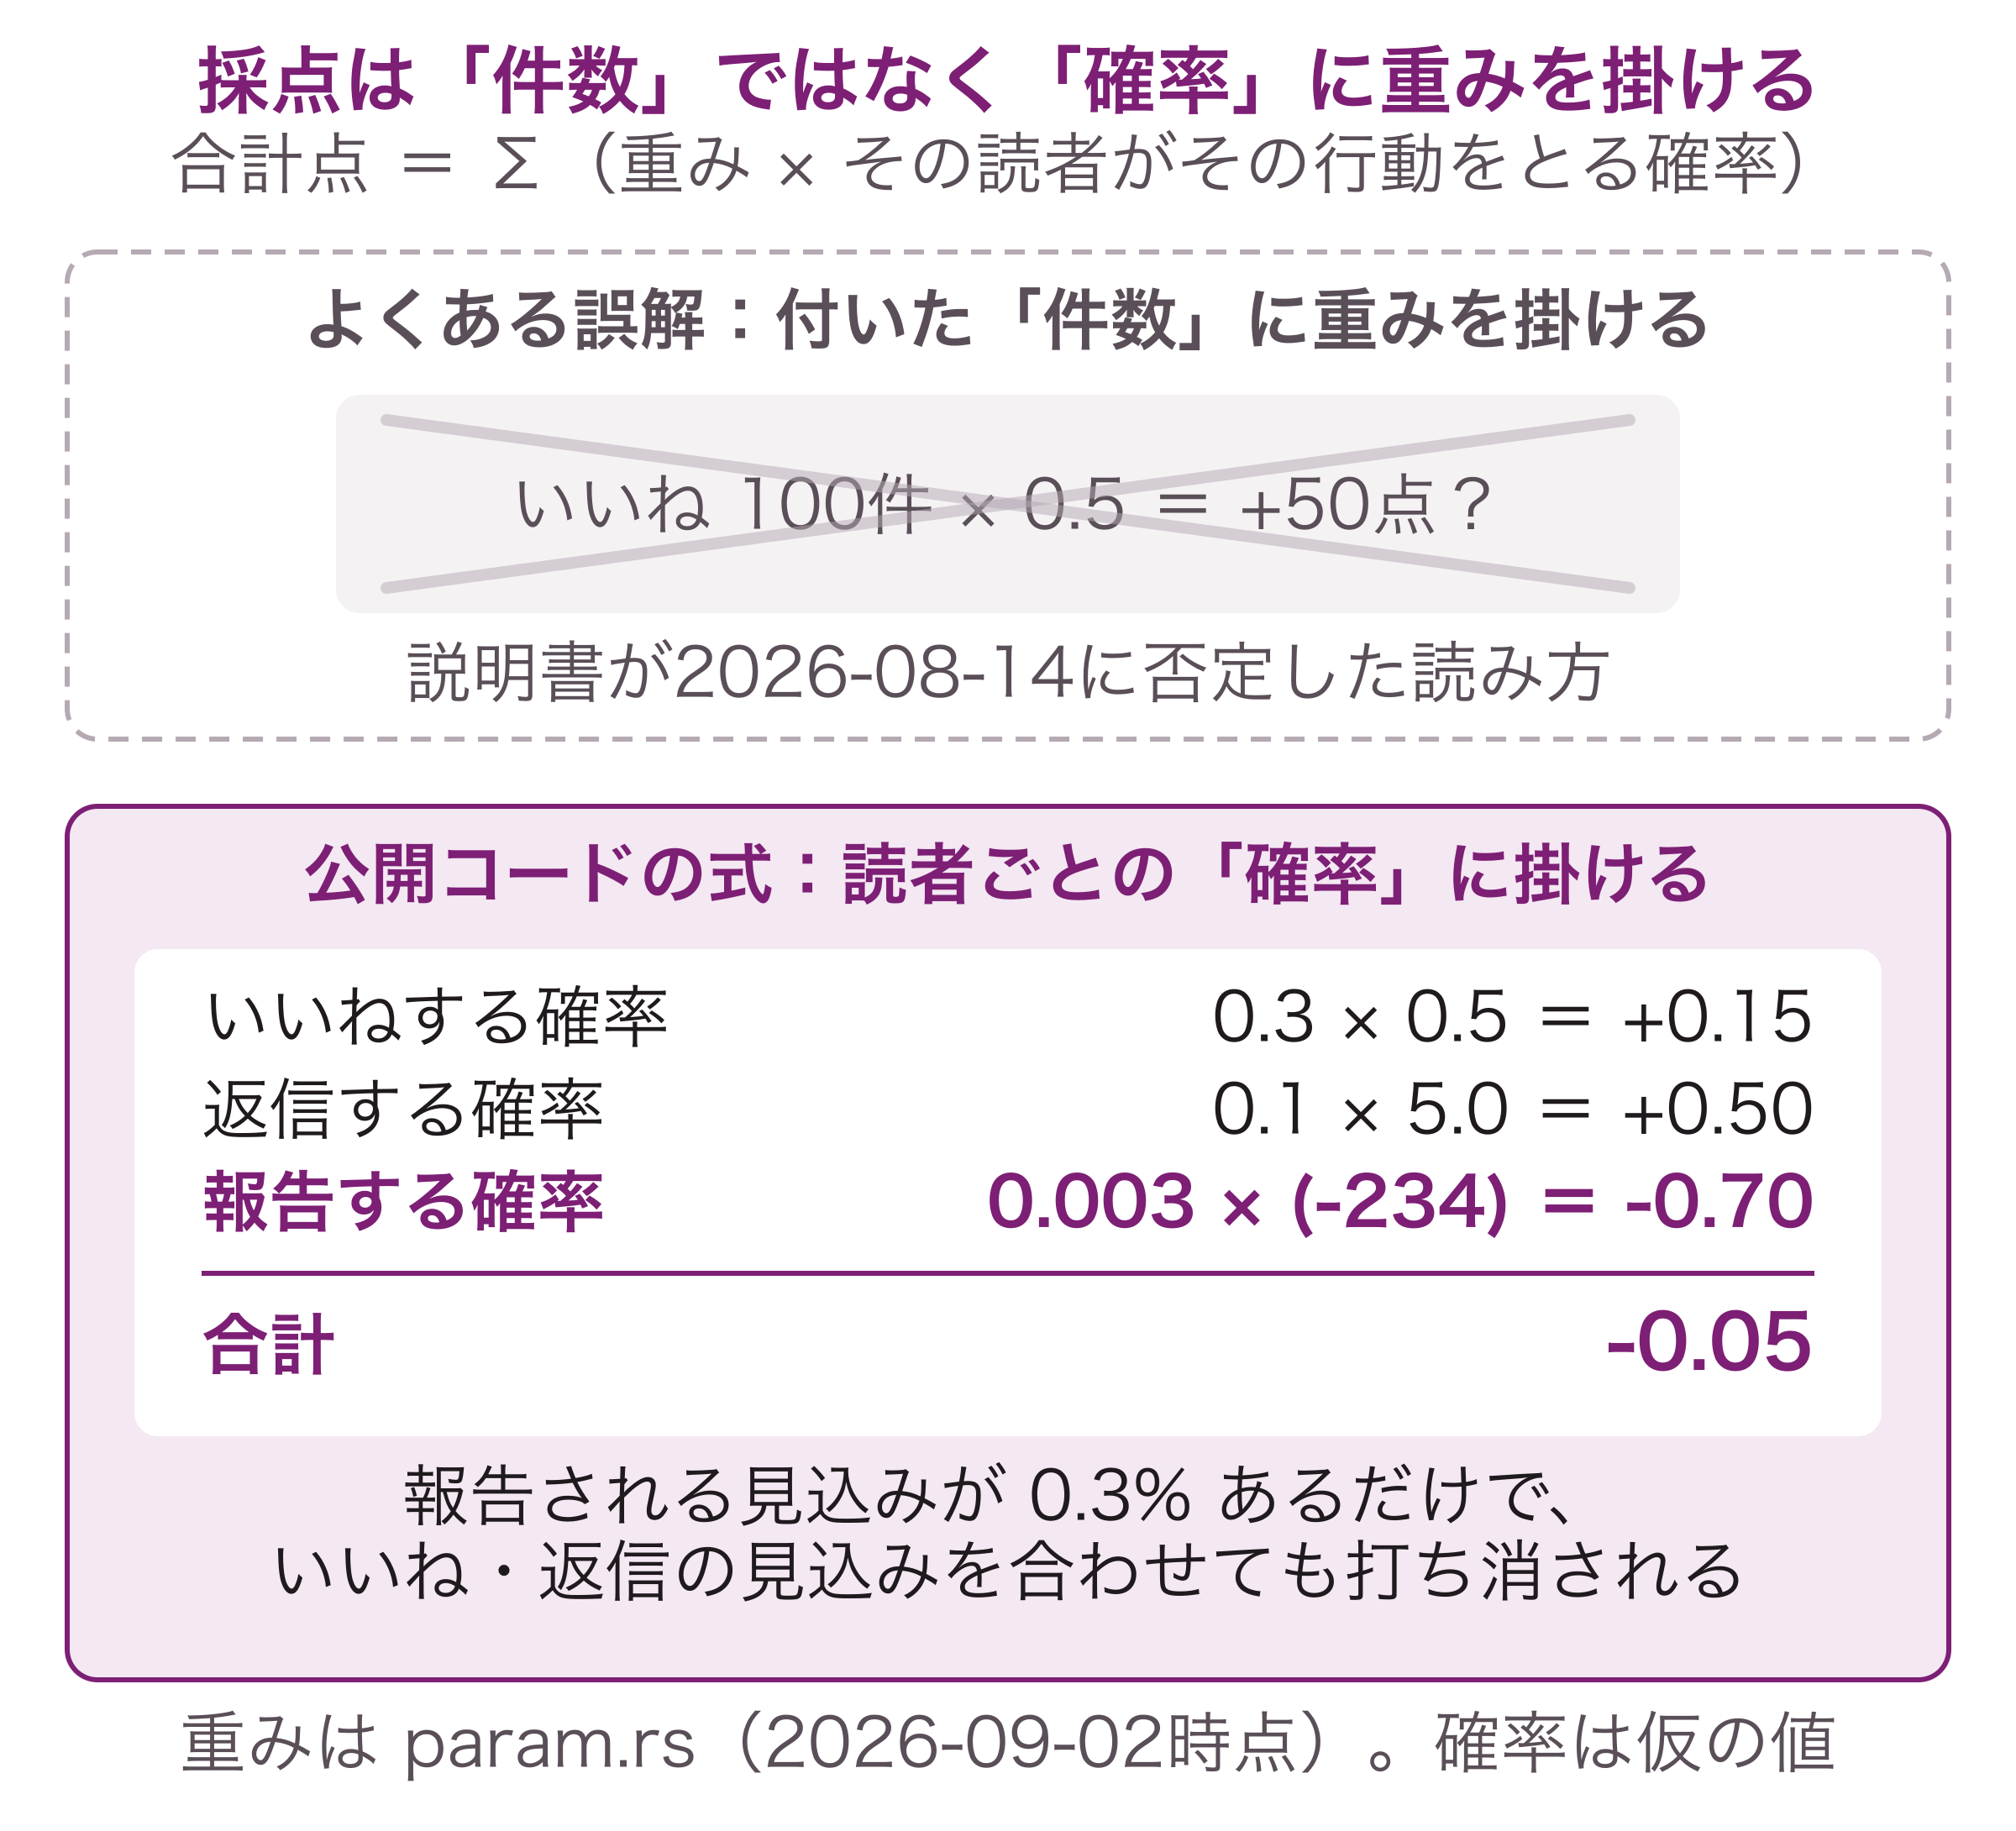
その確率に次章の重みを掛けて合計したものが基本スコアだ。説明書の式は明快で、
Final Score = Σ (weight_i × P(action_i)) — xai-org/x-algorithm README
日本語にすると「合計点 = 行動ごとに(重み × その読者がその行動をとる確率)を計算して、全部足したもの」になる。
さらに2026-08-14の更新で、重みは予測確率に掛かるのであって生のエンゲージメント数には掛からない、と明記された。ここは誤解が多い。「いいねが100付いたから+50点」ではなく、「この読者がいいねする確率が0.3なら0.5×0.3」という計算だ。
ただし合計のあとに、並びを見て点を動かす調整が3つ入る(説明書「How It Works」)。
| 調整 | 内容 | 設定値(重みの設定ファイル) |
|---|---|---|
| 著者の分散 | 同じ著者の2件目以降は減衰係数を掛け、下限まで下げる | — |
| 外輪割引 | フォローしていないアカウントの投稿に1未満の係数を掛ける | OonWeightFactor = 0.75(トピック経由は 0.5) |
| 新規著者ブースト | 表示回数が閾値未満の著者の投稿を目標位置まで持ち上げる | — |
最後にVMRankerという仕上げの係が、似た投稿が続かないように散らしてから上位を選抜する。
6. 重みの一覧:会話は10倍、否定は桁違い
重みの実物はhome-mixer/params/param.rsにある。2026-09-02時点の主な値を挙げる(ごく小さい重みなど一部は省略した。全量はリンク先の実物で見られる)。肯定と否定で表を分けた。分けるだけで、桁の違いが見えるからだ。
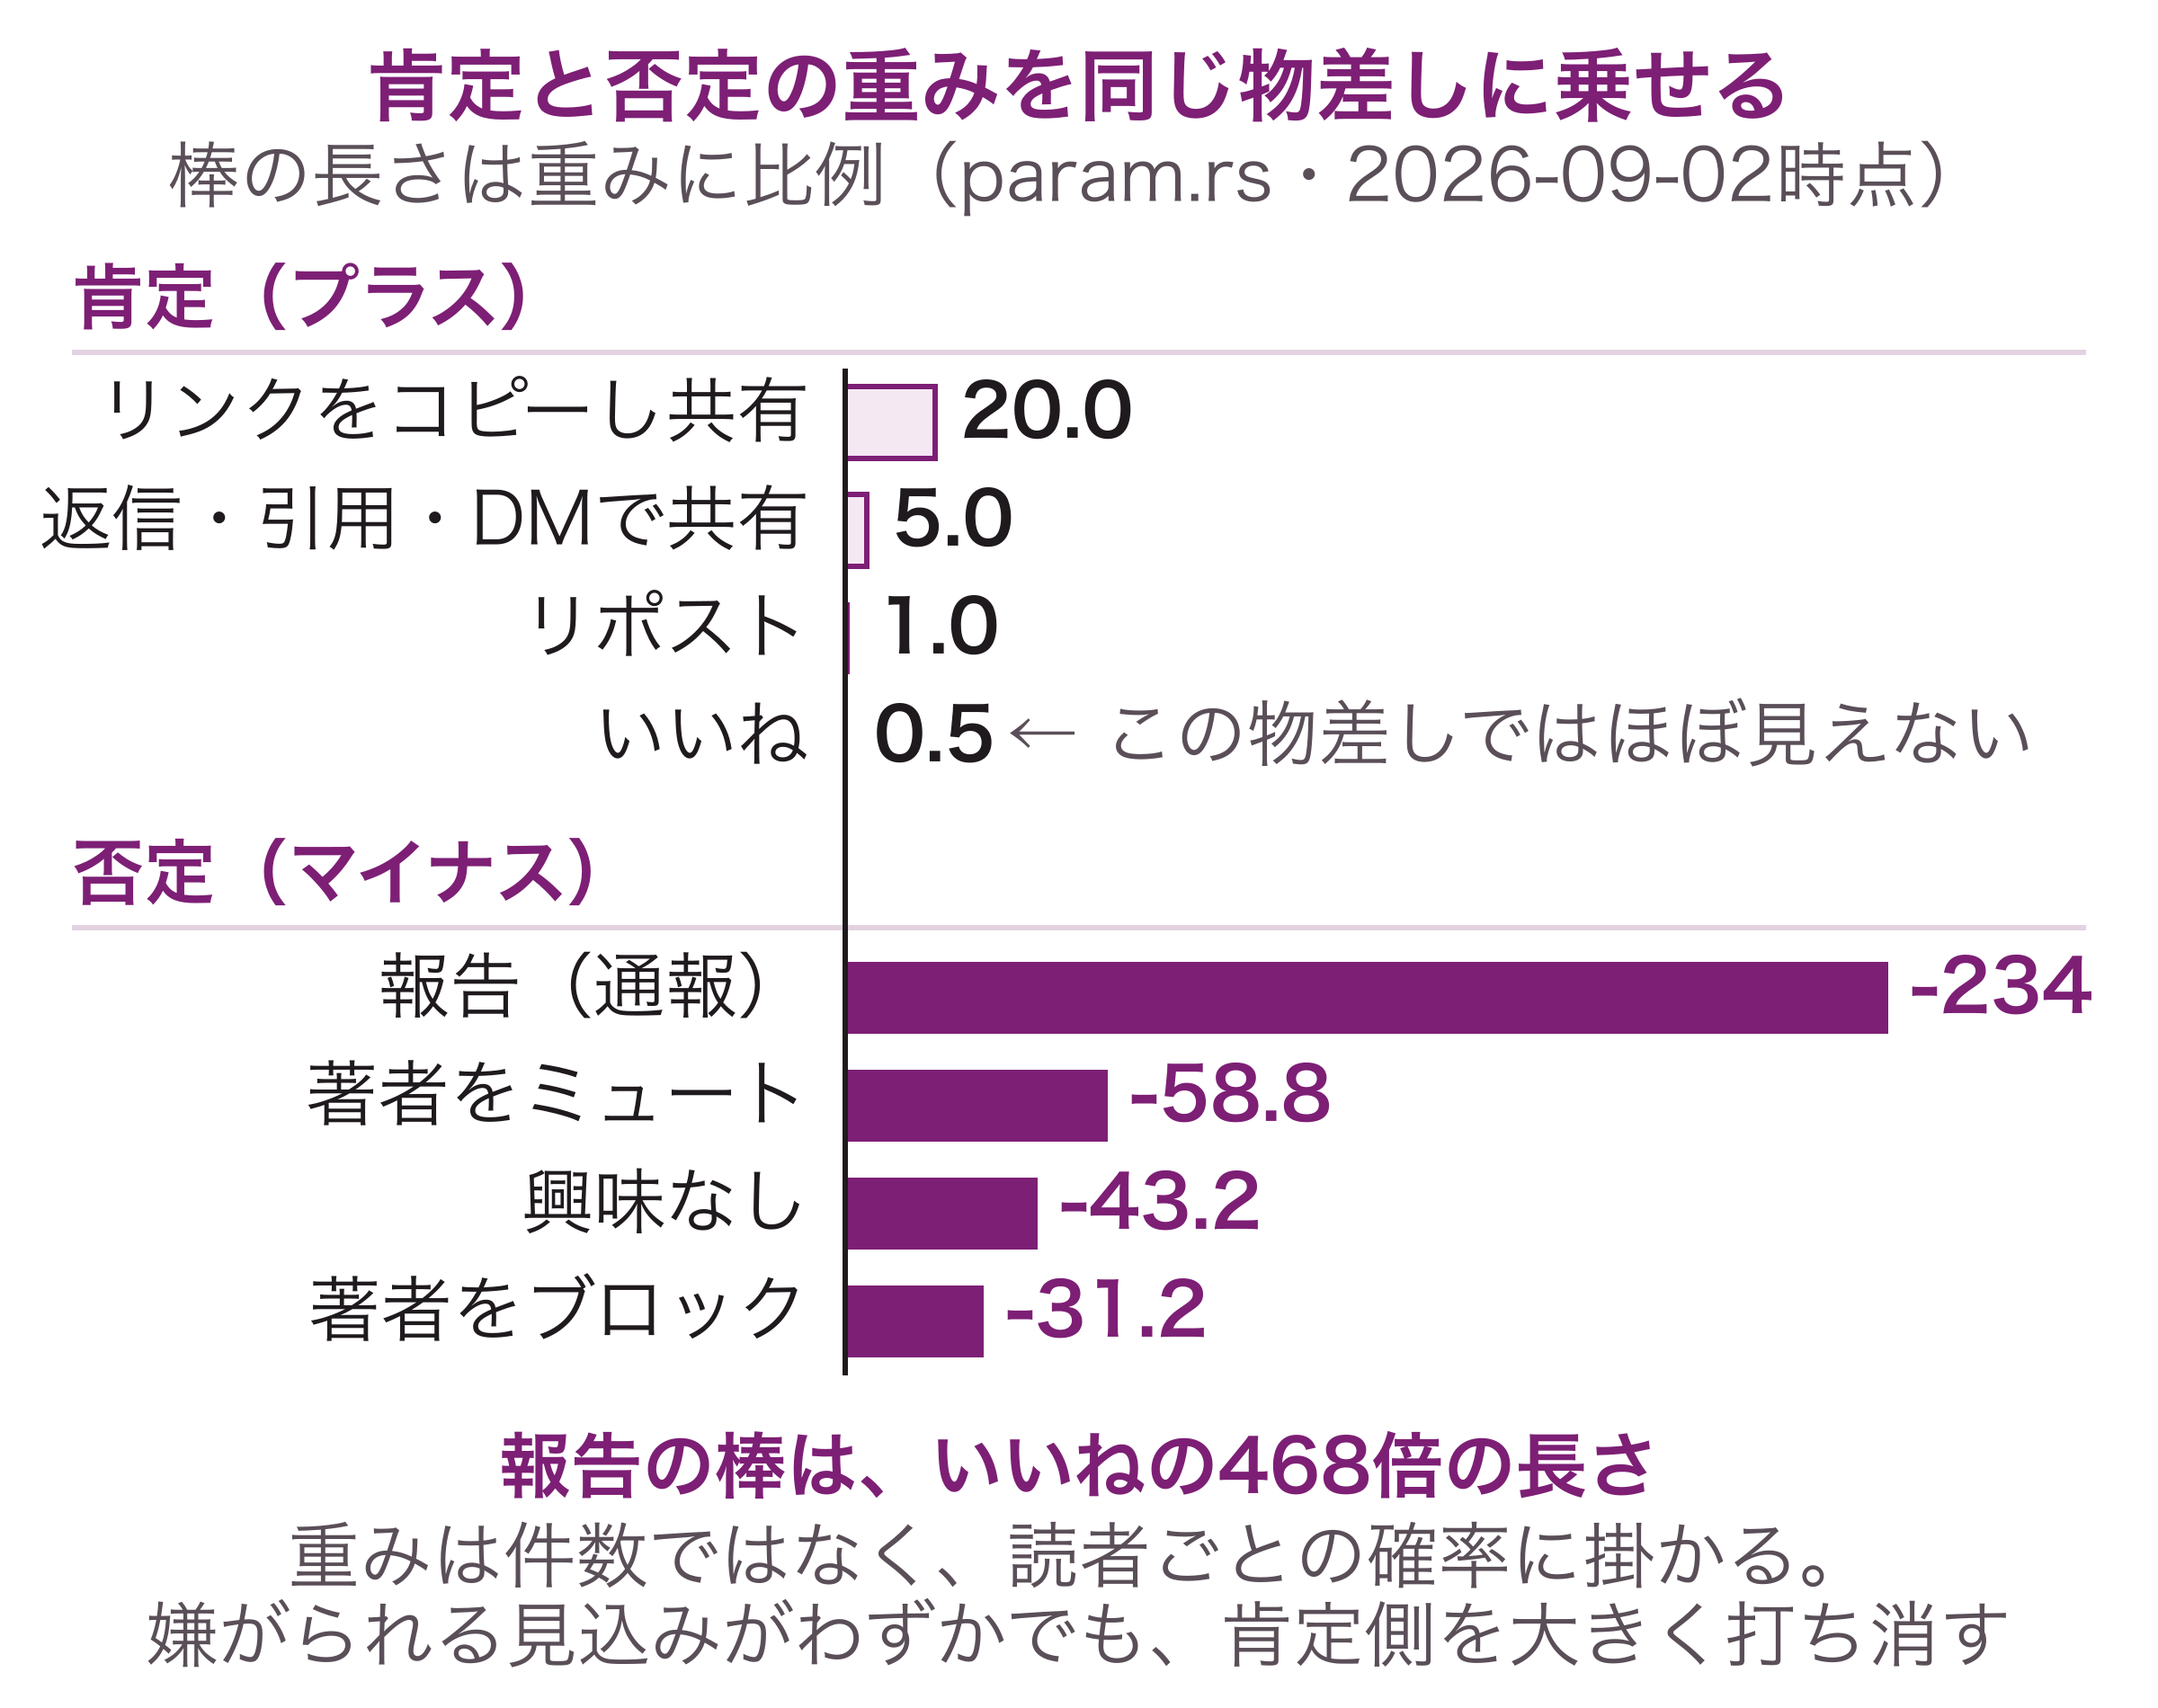
まず肯定側。
| 行動(識別子) | 重み |
|---|---|
| リンクをコピーして共有(ShareViaCopyLinkWeight) | 20.0 |
| 相互フォロー相手からの返信への加算(BidirectionalFollowReplyWeightBoost) | +15.0 |
| 返信(ReplyWeight) | 5.0 |
| 引用(QuoteWeight) | 5.0 |
| DMで共有(ShareViaDmWeight) | 5.0 |
| 著者をフォロー(FollowAuthorWeight) | 4.0 |
| 共有(ShareWeight) | 2.0 |
| リポスト(RetweetWeight) | 1.0 |
| いいね(FavoriteWeight) | 0.5 |
| 投稿をクリック(ClickWeight) | 0.4 |
| リンクを開く(OpenLinkWeight) | 0.2 |
| 動画を開く(VideoOpenWeight) | 0.07 |
| 画像を開く(PhotoExpandWeight) | 0.05 |
| 滞在(DwellWeight) | 0.05 |
| プロフィールをクリック(ProfileClickWeight) | 0.0 |
次に否定側。行数は少ないが、値の桁が違う。
| 行動(識別子) | 重み |
|---|---|
| 報告(ReportWeight) | -234.0 |
| 著者をミュート(MuteAuthorWeight) | -58.8 |
| 興味なし(NotInterestedWeight) | -43.2 |
| 著者をブロック(BlockAuthorWeight) | -31.2 |
| 滞在しなかった(NotDwelledWeight) | -0.02 |
この表から読み取れることは3つある。ここからは私の解釈を含む。
- 会話は、いいねの10倍重い。 返信5.0・引用5.0はいいね0.5の10倍。相互フォロー相手からの返信には+15.0が上乗せされる。「いいねを集める」より「返したくなる」投稿の方が採点上は有利だ。
- 否定は、桁が違う。 ここで「報告1件=いいね468件ぶんのマイナス」と数えたくなるが、それは正確ではない(重みは件数ではなく確率に掛かる・§5)。正しくは「その読者に報告されそうな気配がわずかにあるだけで、いいねされる見込みがどれだけ高くても採点上は打ち消される」ということ。届く範囲を広げるほど、興味のない読者に当たる確率も上がる。
- リンク共有が20.0で突出している。 「リンクをコピーして誰かに送る」は、もっとも強い肯定シグナルとして扱われている。読んだ人が「誰かに見せたい」と思う内容かどうか、という問いに置き換えられる。
重みは実際に動く:20.0から15.0への記録
値が変わる実例も公開されている。docs/BIDIRECTIONAL_BOOST_CHANGE.mdによれば、相互フォロー相手の返信への加算は2026年7月24日に20.0から15.0へ下げられた。理由は「実験結果と、Xでのフィードバック。例えばワールドカップの話題をもっと見たいのに、あまり流れてこなかった人がいた。話題の多くがフォローしていないアカウントの投稿だったからだ」というもの(原文を要約)。仲間内の会話を強くしすぎると外の話題が入ってこなくなる、という調整だ。
説明書には「本番の値を定期的に公開コードへ反映する自動処理を回している」とも書かれている。値そのものより、値が動く理由(多様性と会話のバランス)を追う方が長持ちする。
7. 表示可否は採点とは別の関門
第7段階の表示可否は、見せてよいかを判定する部品(visibility-filtering)、ラベル付けのルールを当てる部品(scarecrow)、そのルールを書く仕組み(§1のBotmaker)の3つが担う。ここに入る材料が、検品モデルGroxによる分類(スパム・成人向け・暴力的メディアなど)と、アカウント単位の信用スコアだ。
「シャドウバンされているのでは」という疑問に対しては、今回「Under the Hood」という、自分のアカウントと投稿に付いたラベルの集計を見られるツールが用意された(説明書「Under the Hood Label Transparency Tool」)。TechCrunchによれば、過去1か月分の集計をJSONファイルで書き出し、公開コードと一緒に好きなAIに読ませて「自分のアカウントに何が起きているか」を説明させる使い方が想定されている。
8. Grokはどこで使われているのか
「アルゴリズムはGrokになった」と語られがちだが、公開コードでは役割が3つに分かれている。
- 採点係のPhoenix。Grok-1から移植したAIモデルが出発点で、現在は本番実装を公開している(§5)
- 検品係のGrox。投稿された瞬間に本文と画像・動画を読み、スパム等の分類と後段モデル用の数値表現を作る。プロンプト本文は非公開
- 非公開の違反予測。Grokでルール違反を予測する部分は、今回も公開されていない(TechCrunch)
つまり「Grok対策」という特別な何かは無い。内容が全文読まれ、読者ごとに64種類の行動確率で採点されるのだから、表面のタグや定型テクニックが効きにくくなった、と理解する方が実態に近いと私は考えている。
9. 投稿設計への翻訳:8項目のチェックリスト
ここからは私の運用の話になる。私はExos AIというX運用ツールを個人で運営していて、生成プロンプトの規約をこの構造に合わせている。効果量(何%伸びたか)は未計測なので、「公開された採点基準に設計を合わせている」という話として読んでほしい。
| # | 設計 | 根拠になる仕組み |
|---|---|---|
| 1 | 1ポスト1内容・60〜120字目安 | 詰め込むほど「誰向けか分からない投稿」になり、興味のない読者に当たる機会が増える(否定シグナルは-31.2〜-234)。字数はコードから導ける値ではなく、私の運用値 |
| 2 | 1ポスト目は単独で意味が通るフックにする | スレッドでもタイムラインに出るのは原則1ポスト目(これはXの表示仕様の話で、公開コードから導いた事実ではない)。ここで返信・引用(各5.0)が生まれる |
| 3 | 「誰かに送りたくなる」1行を入れる | リンクコピー共有20.0・DM共有5.0が最も重い肯定 |
| 4 | ハッシュタグは使わない | 内容は本文・画像から直接読まれる(意味ID・§5)ので、タグで内容を伝える必要が無い。「タグが減点される」証拠は無く、不要と判断して外している私の運用値 |
| 5 | ニュース系は当日中に投稿する | 48時間で候補から外れる(§4) |
| 6 | 相互フォローの相手と会話する | 返信への+15.0加算(下げられても依然大きい) |
| 7 | 短時間に連投しない | 同じタイムライン表示に自分の投稿が2件以上入ると、2件目以降は「著者の分散」で減衰する(§5) |
| 8 | 外部リンクは貼ってよい。ただし本文だけで価値が伝わる形にする | リンクの存在自体への減点は読んだ範囲に無いが、開く行動の重みは+0.2と小さい。開かれなくても評価される本文が要る |
10. やらないこと・落とし穴
逆に、やらない方がよいと考えていることも4つ挙げておく。
エンゲージメントベイト(「RTした人フォローします」型)はやらない。返信・リポストを稼げても、興味のない読者に届いた瞬間「興味なし-43.2」「ミュート-58.8」を積む。桁が違う以上、割に合わないと考えている。
「リンクを貼ると死ぬ」という定説も鵜呑みにしない。上の表のとおり、リンクの存在自体への減点は見当たらない。ただし採点(§5)と表示可否(§7)は別で、スパム判定側にリンクの扱いがあるかは非公開部分に含まれうる。ここは断定しない。
今日の重みを暗記しない。値は動く(§6の20→15)。「否定が桁違いに重い」「実数でなく予測確率に掛かる」「並べると見せるは別」の3点だけ覚えればよい。
「伸びない=シャドウバン」と即断しない。まずUnder the Hoodでラベルの有無を見る。ラベルが無ければ、採点で沈んでいる(届いた読者に嫌がられている)可能性の方を疑う。ラベルがあれば、表示可否で止められている方だ。該当する種類の投稿(成人向け・スパム的な誘導など)をやめて様子を見るのが先だと考えている。ラベルは投稿単位とアカウント単位があるので、どちらに付いているかも見ておきたい。
参考資料(一次資料を優先)
| 種別 | 資料 | 何が分かるか |
|---|---|---|
| 一次 | xai-org/x-algorithm README | 公開コードの説明書。8段階のパイプライン、採点式、3つの調整、公開/非公開の範囲、更新履歴 |
| 一次 | home-mixer/params/param.rs | 重みの実値(本記事の表) |
| 一次 | phoenix/README.md | 採点モデルの入出力(64行動+8連続値・意味ID・候補どうしが互いを参照しないこと) |
| 一次 | docs/BIDIRECTIONAL_BOOST_CHANGE.md | 重みが変わった実例(20.0→15.0・2026-07-24)と理由 |
| 一次 | 初回公開コミット aaa167b3 | 2026年1月の全面書き直し版の中身(Rust/Python製・79ファイル・約8,800行) |
| 一次(旧版) | twitter/the-algorithm(2023) | 旧構造(候補1,500件・内外半々・Heavy Ranker)との比較 |
| 二次 | TechCrunch 2026-01-20 | 1月公開の位置づけ、4週間ごとに公開コードを更新して透明性を示すというマスク氏の約束 |
| 二次 | TechCrunch 2026-08-13 | 8月公開の位置づけ、非公開部分(Grokの違反予測)、Under the Hood の使い方 |
まとめ
持ち帰りは1つ。Xのおすすめは加点計算ではなく、減点が桁違いに大きい採点だということ。いいねを増やす施策より先に「興味のない人に届いたとき嫌がられないか」を確認する方が、公開された採点基準に合っている。
次にやることも1つ。直近10投稿を見返して「誰向けか1行で言えない投稿」を数えてみてほしい。多いほど、興味のない相手に当たって否定シグナルをもらう機会が増える。Exos AIの同梱プロンプトも、この採点基準に合わせて書いている。